LLM SEO: damit KI-Engines deine Website lesen können
Wenn GEO das ist, was du veröffentlichst, geht es bei LLM SEO darum, ob Maschinen es abrufen und lesen können. Zuerst kommen die Crawler-Freigaben, dann indexierbare Seiten und strukturierte Daten, die zum sichtbaren Inhalt passen. Sperrst du den falschen Crawler aus, überspringen ChatGPT, Claude oder Perplexity deine Seiten womöglich, ohne dass du es merkst. 94 % der B2B-Käufer recherchieren Anbieter in einer KI-Engine, bevor sie eine SERP anklicken. Die technische Schicht unter dieser Zahl entscheidet, wer zitiert wird.
Die Engine-Landschaft · auf einen Blick
| Engine | Was es ist | Von Truffle gemessen |
|---|---|---|
| KI-Assistenten | ||
| OpenAI (ChatGPT) | Läuft in jedem Projekt | ✓ |
| Anthropic (Claude) | Läuft in fast jedem Projekt | ✓ |
| Google Gemini | Läuft in jedem Projekt | ✓ |
| Perplexity | Läuft in jedem Projekt | ✓ |
| xAI (Grok) | Pro Projekt zuschaltbar | ✓ |
| Google-Suchflächen | ||
| Google AI Overviews | Erscheint bei 20 % der Keywords (Sistrix, Deutschland, Feb. 2026) | ✓ |
| Google AI Mode / SERP Top 10 | Referenz-Basislinie für dasselbe Query-Set | ✓ |
Welche Engines laufen, ist pro Projekt konfigurierbar, und ein Lauf misst mehrere davon nebeneinander — es gibt kein Leitmodell, an dem der Rest gemessen wird. In jedem Bezahlplan enthalten ab $69/Monat, kein Add-on pro Engine, kein Sales Call. Modellversionen wechseln alle paar Monate, deshalb nennt diese Tabelle Anbieter statt Versionsnummern.
Was ist LLM SEO?
LLM SEO (Large Language Model SEO) ist die Disziplin, die technische Infrastruktur einer Website so vorzubereiten, dass KI-Engines ihre Inhalte mit geringer Mehrdeutigkeit und hoher Präzision crawlen, parsen, indexieren und abrufen können.
Es ist die Voraussetzungsschicht des AI SEO. GEO entscheidet, was du publizierst, damit Modelle dich zitieren. LLM SEO entscheidet, ob Modelle diesen Content technisch überhaupt erreichen und verarbeiten können.
Ein technischer Vorschlag aus diesem Feld ist die llms.txt von Jeremy Howard (Answer.AI), zuerst veröffentlicht im September 2024: eine Markdown-Zusammenfassung für LLMs, im Root der Website oder seit Version 2 des Vorschlags auch unter einem beliebigen Pfad, benannt nach dem Vorbild von robots.txt. Sie adressiert ein Problem, das die ganze Disziplin teilt: LLMs tun sich schwer, saubere, kanonische Informationen aus Sites zu extrahieren, die für klassische SEO-Oberflächen optimiert sind.
Was das praktisch bedeutet:
Für Google baut es auf technischem SEO auf. Laut Google gibt es für AI Overviews und AI Mode keine technischen Anforderungen über die normale Eignung für die Suche hinaus. Bei den anderen Engines ist das anders: ChatGPT, Claude und Perplexity crawlen mit eigenen Bots, und jeden davon kannst du einzeln erlauben oder sperren.
Strukturierte Daten müssen zur Seite passen. Genau das verlangt Google, und für seine KI-Funktionen braucht es kein spezielles Markup. Dazu kommen Entity Resolution, AI-Crawler-Freigaben in der robots.txt und die Validierung des Markups. Eine llms.txt ist eine optionale Ergänzung.
Suche und Training laufen über verschiedene Crawler. Bei OpenAI kannst du OAI-SearchBot erlauben, der Seiten in die Suchantworten von ChatGPT bringt, und trotzdem GPTBot sperren, der Trainingsdaten sammelt. Anthropic trennt Claude-SearchBot und ClaudeBot auf dieselbe Weise. Wer einen Such-Crawler sperrt, verliert Sichtbarkeit in den Antworten dieser Engine, egal was Google mit derselben Seite macht.
Glossar · vier kanonische Begriffe
robots.txt, die bestimmte AI-Crawler erlauben/blockieren (OAI-SearchBot, GPTBot, Claude-SearchBot, ClaudeBot, PerplexityBot, Google-Extended)Die Multi-Engine-Landschaft der KI-Suche
Die KI-Suchoberfläche ist nicht mehr „ChatGPT und der Rest". Jede Engine treibt inzwischen eine substanziell andere Query-Verteilung. Wer für eine optimiert und den Rest ignoriert, lässt die anderen unbeobachtet.
| Engine | Anbieter | Query-Typ | Crawler | Indexierungsquelle |
|---|---|---|---|---|
| ChatGPT (Chat) | OpenAI | Konversationell | GPTBot | Trainingskorpus + Live-Web (Plus) |
| ChatGPT Search | OpenAI | Suchartig | OAI-SearchBot | Live-Web |
| Claude | Anthropic | Konversationell | ClaudeBot · Claude-SearchBot | Trainingskorpus + Tool Use |
| Perplexity | Perplexity | Suchen + Zitieren | PerplexityBot | Live-Web, jede Anfrage |
| Gemini | Konversationell | Google-Extended | Trainingskorpus + Google-Index | |
| Google AI Overview | In SERP eingebettet | Googlebot | Google-Index + KI-Synthese |
Die technische Konsequenz
Wer Google-Extended erlaubt, kommt dadurch nicht in die AI Overviews. Google schreibt, dass der Crawler keinen Einfluss auf die Aufnahme in die Google-Suche hat, und AI Overviews und AI Mode sind Funktionen der Suche, die Googlebot folgen (Google). ChatGPT, Claude und Perplexity erreichst du über ihre eigenen Such-Crawler, OAI-SearchBot, Claude-SearchBot und PerplexityBot, und die prüfst du getrennt (OpenAI).
Live AI Visibility Check — echte Anfragen tracken, keine Keyword-Übersetzungen
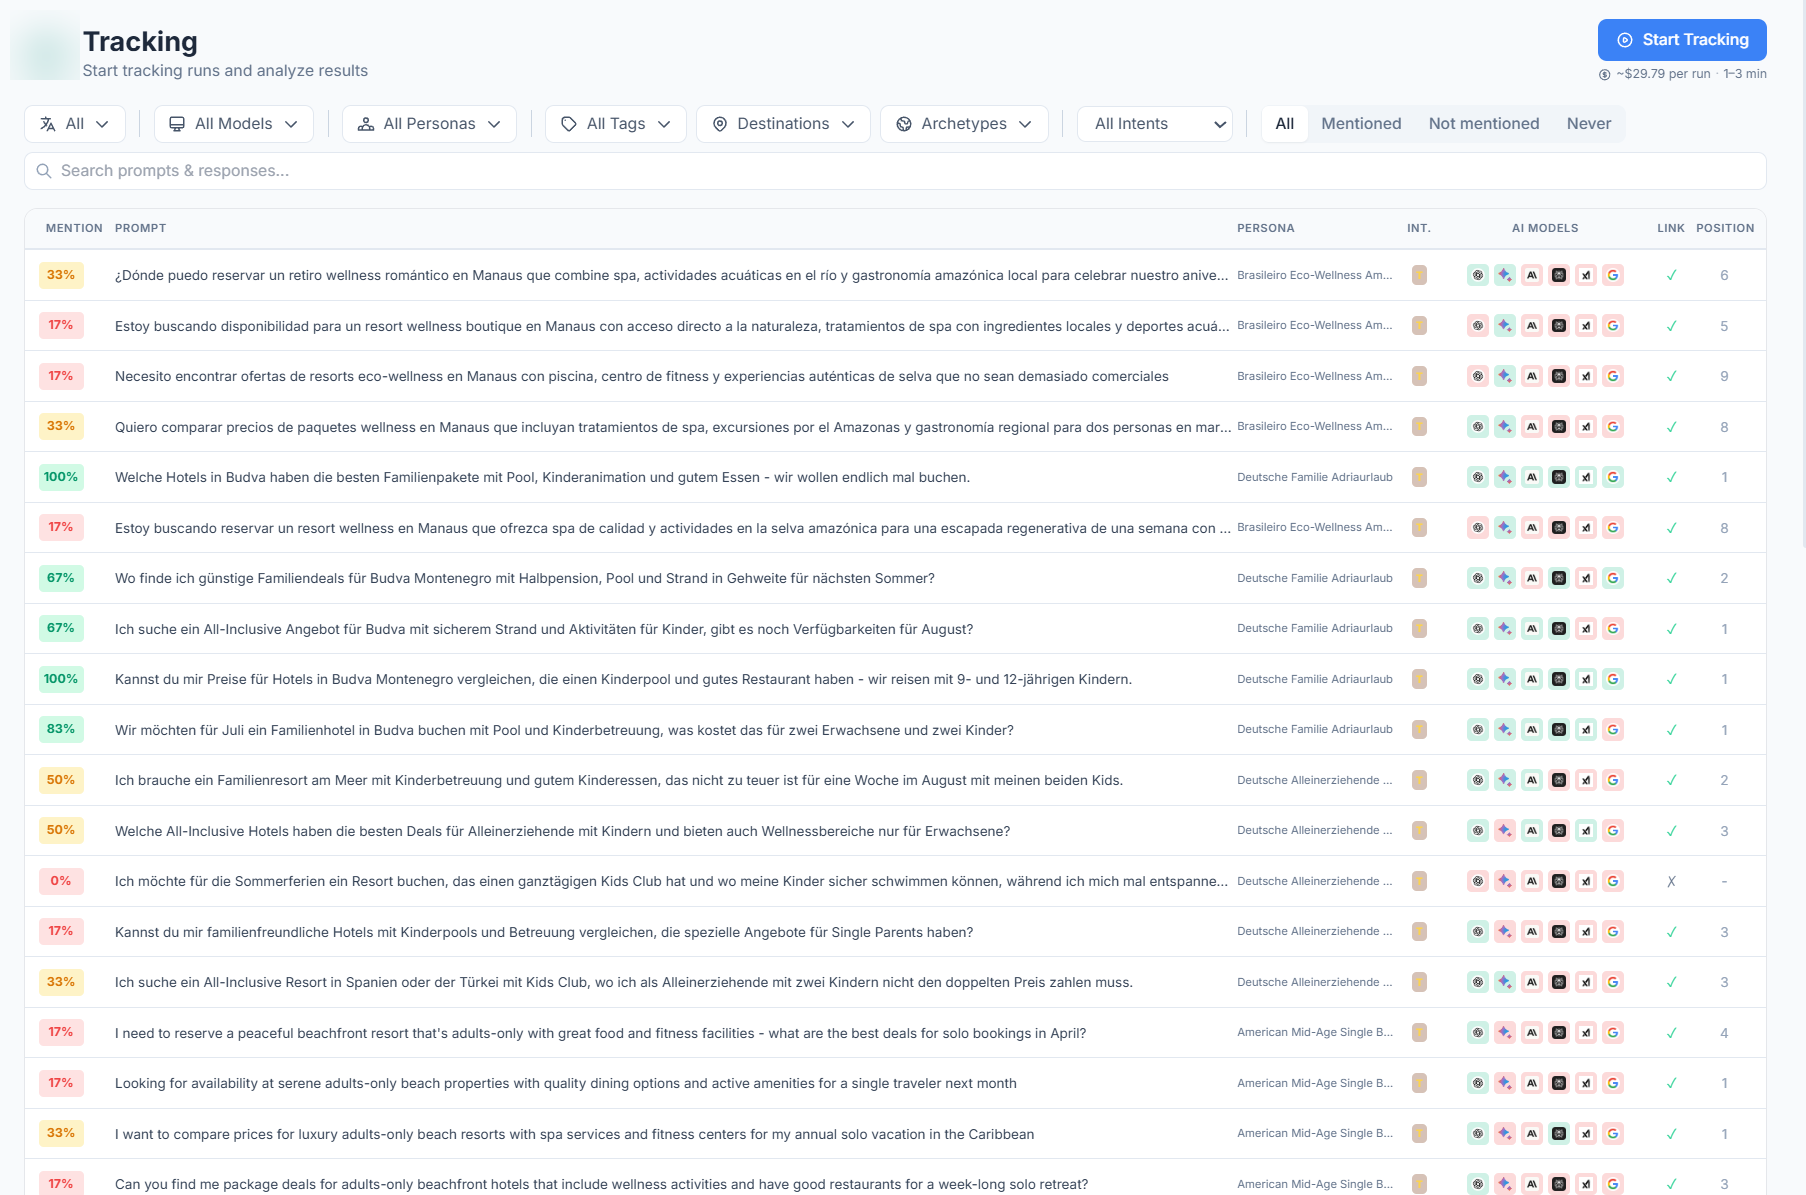
Die meisten LLM-SEO-Tools simulieren Prompts, indem sie SEO-Keywords übersetzen ("best CRM" → "What is the best CRM?"). Das verfehlt, wie Käufer tatsächlich fragen. Truffles Live AI Visibility Check fragt generative Antworten in Echtzeit über alle angebundenen Engines ab — mit den echten Prompts deiner Personas, automatisch generiert, validiert und aufgefrischt. Du siehst, was ChatGPT gestern zitiert hat, nicht was es zitieren könnte, wenn deine Prompts perfekt formuliert wären.
Wo LLM SEO im AI-SEO-Stack sitzt
Das 6-Schritte-LLM-SEO-Implementierungs-Playbook
Die Änderungen selbst sind klein. OpenAI und Perplexity nennen rund 24 Stunden, bis sie eine geänderte robots.txt übernehmen. Ob du danach zitiert wirst, zeigt erst die laufende Messung.
AI-Crawler-Freigaben in der robots.txt
Bevor irgendein LLM deine Site lesen kann, muss deine robots.txt es erlauben. Explizite Deklarationen reduzieren Mehrdeutigkeit:
User-agent: OAI-SearchBot
Allow: /
User-agent: Claude-SearchBot
Allow: /
User-agent: PerplexityBot
Allow: /
# Training und Gemini: deine Entscheidung
User-agent: GPTBot
Allow: /
User-agent: ClaudeBot
Allow: /
User-agent: Google-Extended
Allow: /
Häufiger Fehler: alte Disallow: *-Regeln aus Privacy-Audits, die AI-Crawler still blockieren.
llms.txt-Datei im Root oder unter einem Pfad
Der llms.txt-Vorschlag von Jeremy Howard (Answer.AI) definiert eine Markdown-Datei im Root deiner Domain oder unter einem Pfad wie /docs/, die deine Site oder diesen Bereich für LLMs zusammenfasst. Kein Ersatz für sitemap.xml — eine Ergänzung.
> Beschreibung in einem Satz
## Was wir tun
- Capability 1
- Capability 2
## Wichtige Ressourcen
- [Preise](/pricing)
- [Docs](/docs)
Adoption: 8,7 % der Top-1000-Sites (Rankability, Juni 2026) — aber 97 % der veröffentlichten Dateien werden von keinem KI-Crawler abgerufen (Ahrefs, 137K Sites). Billig umzusetzen, aber keine Abkürzung.
Schema.org-Markup, FAQ-priorisiert
Schema-Markup signalisiert LLMs die semantische Struktur. Prioritätsreihenfolge für LLM SEO:
1. FAQPage // höchste KI-Dichte
2. Article // redaktionell
3. HowTo // prozedural
4. Organization // Entität
5. BreadcrumbList
FAQ-Blöcke liefern einer Answer Engine fertige Frage-Antwort-Paare — Single Grain führt FAQ-Schema unter den Elementen, die AI Overviews speisen (Single Grain, 2026).
Entity Resolution
LLMs disambiguieren Entitäten (Marke, Person, Produkt, Ort) über kanonische Identifier. Deine Site sollte Entitäten wo möglich mit ihrer Wikidata-Q-ID referenzieren und Schema-sameAs-Verlinkung nutzen.
"https://www.wikidata.org/wiki/Q42",
"https://en.wikipedia.org/wiki/...",
"https://www.linkedin.com/in/..."
]
Häufiger Fehler: 5 unterschiedliche Gründer-Bios auf Blog, About und Pressekit → LLMs lesen 5 widersprüchliche Entitäten.
Validierung strukturierter Daten, Multi-Surface
Schema, das im Google-Rich-Results-Test validiert, parst nicht zwingend korrekt für KI-Engines. Validiere über mehrere Oberflächen:
1. Google Rich Results Test
2. Schema.org-Validator
3. Live-Test auf Perplexity
4. Live-Test auf ChatGPT
Schema, das für Google valide ist, kann für eine Answer Engine trotzdem unbrauchbar sein — meist wegen inkonsistenter JSON-LD-Verschachtelung. Pro Engine testen, nicht einmal.
Multi-Engine-Freigaben-Monitoring (kontinuierlich)
LLMs bringen regelmäßig neue Crawler. Q1 2026 kamen dazu: OAI-SearchBot (ChatGPT Search), Anthropics erweiterter ClaudeBot, Bytespider (TikTok AI).
Mindestens monatlich
Quartalsweise bei wenig Traffic
Die robots.txt muss kontinuierlich aktualisiert werden, nicht jährlich.
Wo KI-Zitate tatsächlich landen
Zitate verteilen sich über die Engines, und die Verteilung unterscheidet sich je Marke und je Query-Set. Wer nur für ChatGPT optimiert, lässt den Rest dieser Oberfläche unabgedeckt — deshalb wird pro Engine gemessen, nicht einmal.
Beispielhafte Aufteilung. Eine öffentliche Branchenmessung der Zitat-Anteile je Engine gibt es nicht — Truffle misst die tatsächliche Verteilung pro Marke.
LLM-SEO-Tools 2026 im Vergleich
Fünf Plattformen, jede für einen anderen Käufertyp gebaut. „Nicht angegeben" heißt: Die Seite des Anbieters nannte zum unten genannten Datum keine Zahl.
| Plattform | Engines im Einstieg | Einstieg |
|---|---|---|
| Truffle | 6 in jedem Plan | $69 |
| Profound | ChatGPT im kostenlosen Trial · bis zu 9 auf Enterprise | Nicht veröffentlicht |
| AthenaHQ | 11 Modelle auf Starter, nach Credits abgerechnet | $295 |
| Schema App | Nicht angegeben | Auf Anfrage |
| WordLift | Nicht angegeben | €799 (Business+) |
Wettbewerbspreise mit Stand 2026-09-17, jeweils von der Preisseite des Anbieters. Anbieter ändern Tarife ohne Ankündigung — bitte vor einer Entscheidung beim Anbieter prüfen.
Welches passt
Wenn deine Lücke nur bei strukturierten Daten liegt, reicht vielleicht ein Schema- oder Entity-Spezialist. Wenn du sehen willst, was jede Engine mit deiner Site macht, und darauf reagieren willst, brauchst du auch Tracking. Truffle ist für Teams gebaut, die den Multi-Engine-Kreislauf aus LLM SEO und GEO in einem Workspace wollen.
Zwei weitere Truffle-Capabilities, die den LLM-SEO-Kreislauf schließen
Capability 1 (Live AI Visibility Check) und Capability 4 (Smart Onboarding) sitzen inline an anderen Stellen dieser Seite. Die Capabilities 2 und 3 unten vervollständigen den täglichen redaktionellen + technischen Kreislauf.
Tools — llms.txt-Generator + Full Audit (Smart Onboarding)
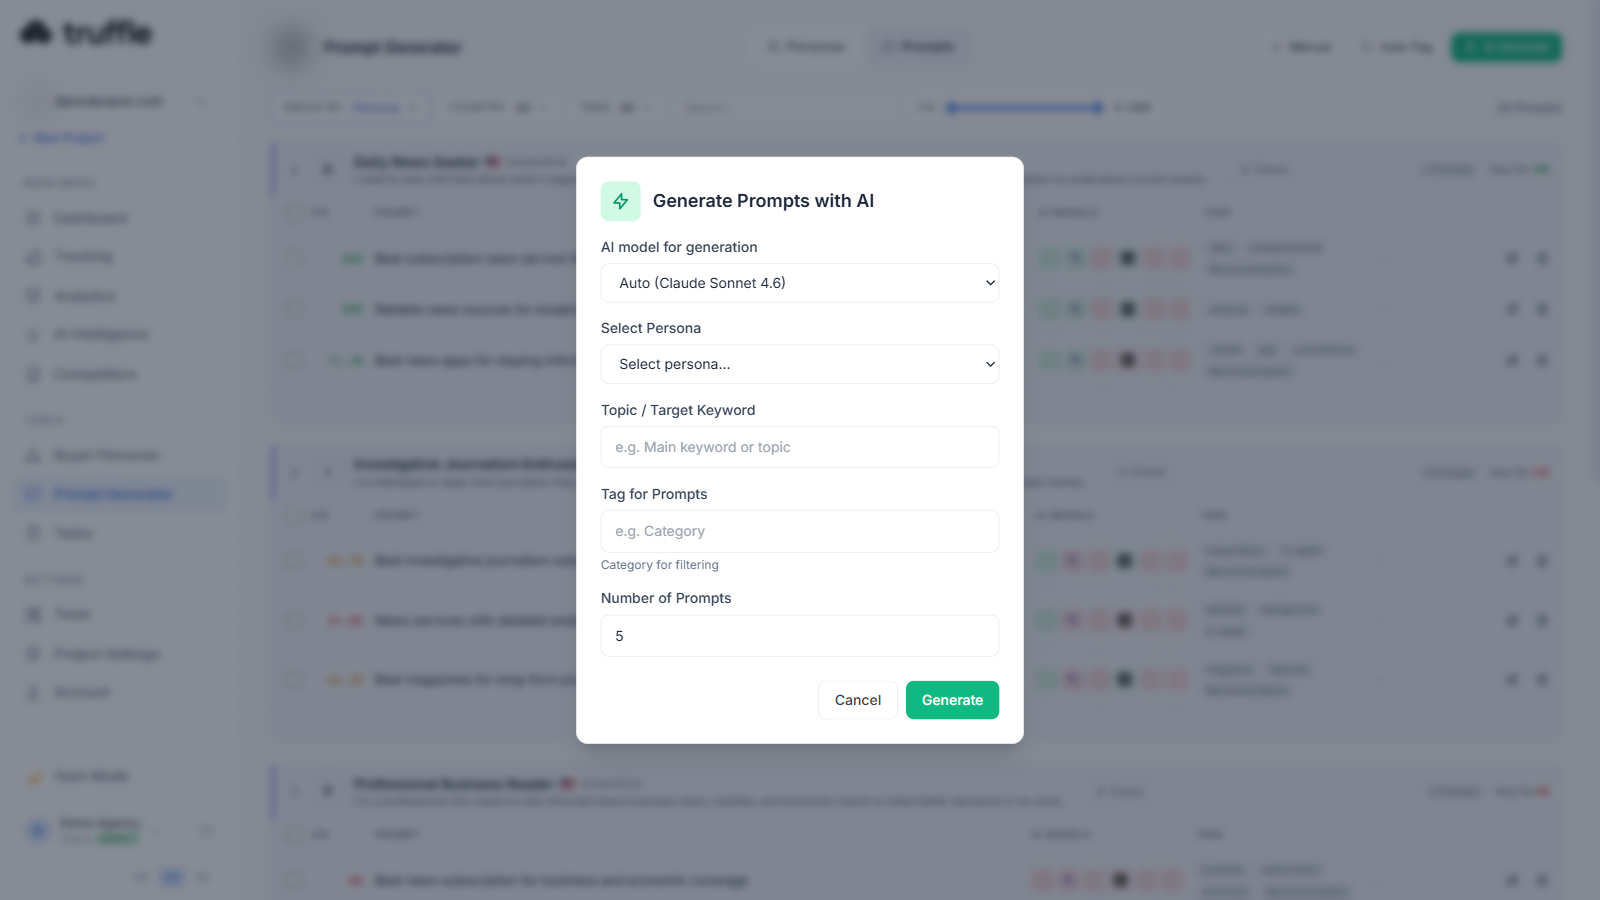
Truffles Tools-Bereich liefert zwei eigens gebaute Utilities für LLM SEO. Der llms.txt-Generator erzeugt eine spezifikationskonforme llms.txt aus deiner robots.txt + Sitemap, damit LLMs deine wichtigen Seiten entdecken. Das Full Audit (Smart Onboarding) testet Schema, robots.txt und KI-Sichtbarkeit auf ChatGPT/Claude/Perplexity/Gemini in einem Durchlauf.
AI Generate · 10-Modell-Prompt-Simulator
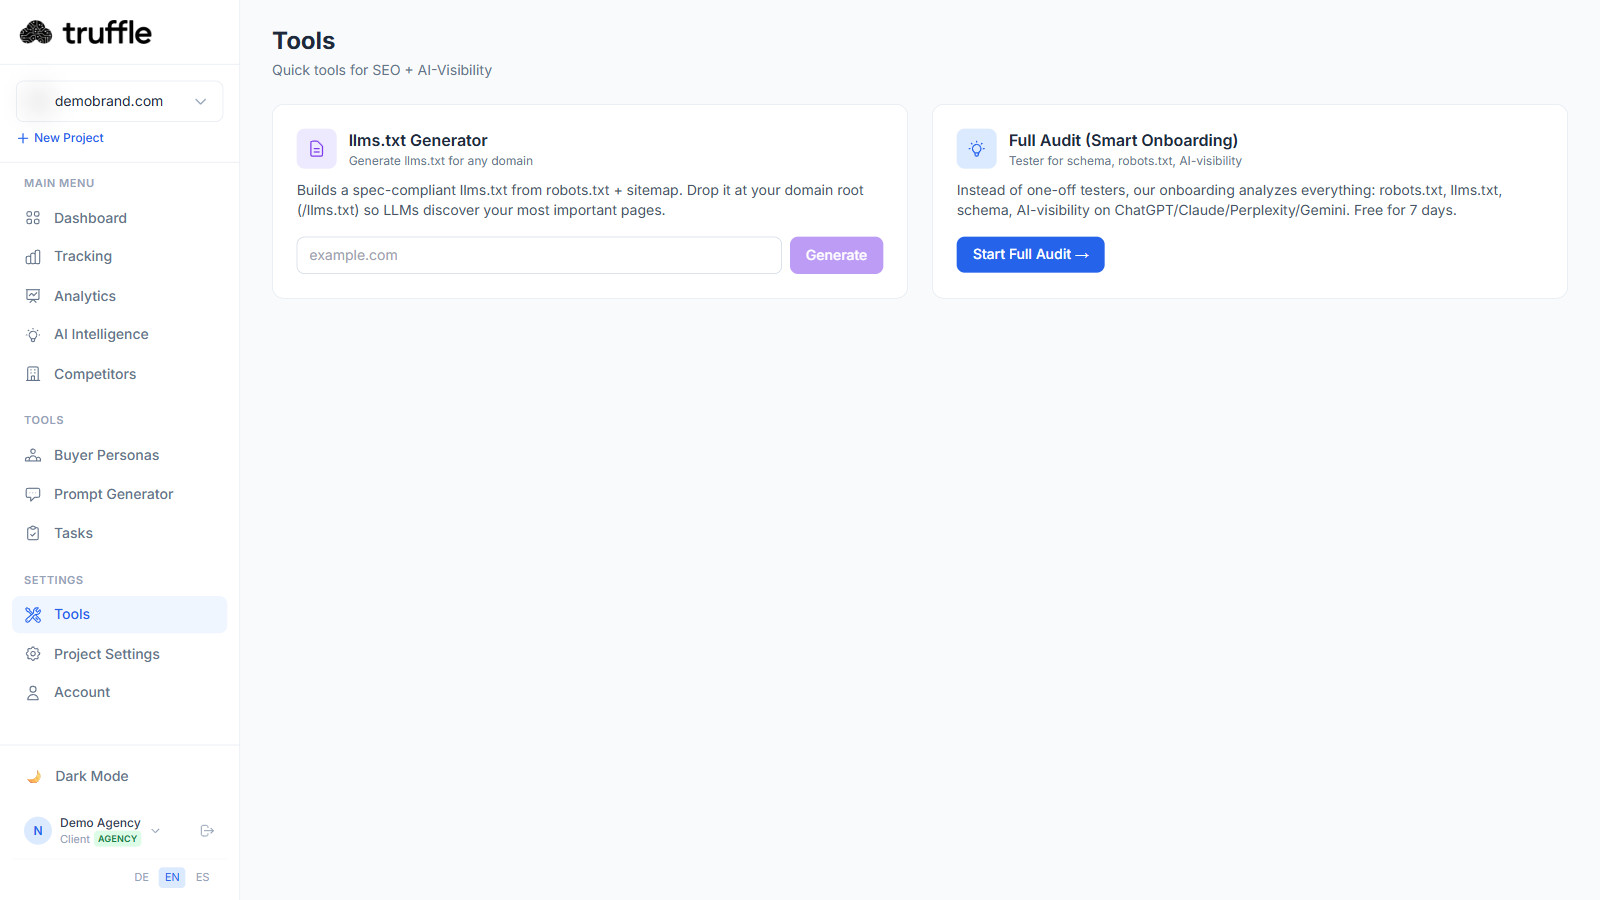
LLM SEO braucht Prompt-Tests über Engines hinweg — ohne 10 separate API-Abos zu bezahlen. Truffles AI Generate fährt simulierte Prompts über dieselben Engines, die das Tracking misst (OpenAI, Anthropic, Google Gemini, Perplexity, xAI sowie AI-Overview- und SERP-Top-10-Simulatoren) — aus einem Interface. Zitierwürdigkeit testen, Entity Resolution der Modelle prüfen, Schema-Varianten entwerfen — alles in einem Workflow.
Der LLM-SEO-Tooling-Markt 2026
Grundlegend und setup-lastig, deshalb ist die Arbeit kleiner als laufende GEO-Services. Der Hebel ist permanent — GEO ohne LLM SEO verliert Zitate.
Klickrate auf Position 1, sobald eine AI Overview darüber steht
der Keywords zeigen eine AI Overview — im Long Tail rund 30 % (Markt Deutschland)
der weltweiten Top-1000-Sites publizieren eine llms.txt — 97 % dieser Dateien werden von keinem KI-Crawler je abgerufen
Hinweis zu den Zahlen oben: Marktgrößen und Adoptionsraten enthalten Experten-Projektionen und Trendmodelle von Marktforschungsfirmen — belastbare Richtungsdaten, aber nicht durch eine einzelne akademische Primärstudie verifiziert. Detaillierte Methodik und Quellenliste auf Anfrage.
Smart Onboarding — Site-Analyse, Personas und Tracking in Minuten startklar
LLM-SEO-Programme brauchen typischerweise 2–4 Wochen Scoping: Site analysieren, Buyer Personas entwerfen, das initiale Prompt-Set bauen, den ersten Visibility Check fahren. Truffle Smart Onboarding führt das komplette Setup als KI-geführten 3-Schritte-Assistenten aus: Website-Analyse (Branche, Zielgruppe, Produkte, Value Proposition, erkannte Wettbewerber mit Confidence Score), Kontext & Daten (GSC- und GA-CSV-Import + Zusatzkontext) und Persona-Auswahl (5 KI-vorgeschlagene Personas mit ihren Tracking-Prompts). Der erste Visibility Check läuft noch in derselben Session.
Demo buchen →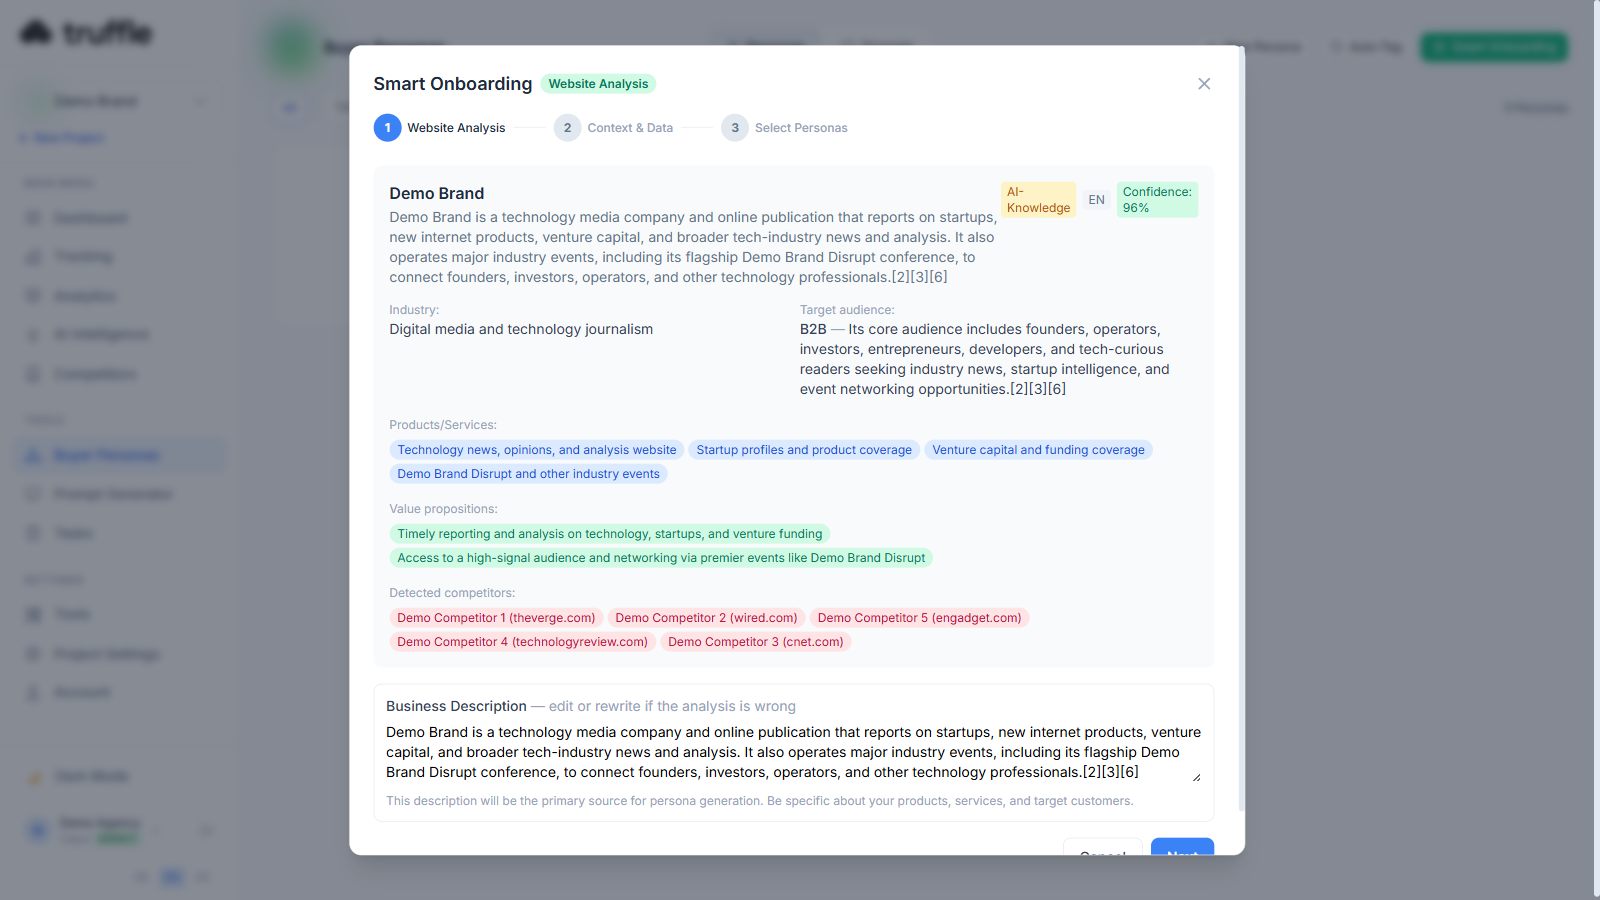
Häufig gestellte Fragen
Was ist LLM SEO?
Wie unterscheidet sich LLM SEO von technischem SEO?
robots.txt erlaubt oder gesperrt. Eine Website kann für Google in bestem Zustand sein und für sie trotzdem verschlossen.Wie unterscheidet sich LLM SEO von GEO?
OAI-SearchBot sperren, nicht in den Suchantworten von ChatGPT erscheinen (als Navigationslink können sie noch auftauchen), egal wie gut der Inhalt ist.Brauche ich eine llms.txt?
llms.txt ist ein Vorschlag von Jeremy Howard, erstmals veröffentlicht im September 2024, der Agenten wie Coding-Assistenten helfen soll, eine Website zu nutzen. In einer Ahrefs-Studie über 137.000 Domains wurden 97 % der veröffentlichten Dateien im Mai 2026 kein einziges Mal abgerufen. Die Datei ist schnell angelegt, ersetzt aber keine Crawler-Freigabe.Welche AI-Crawler sollte ich erlauben?
OAI-SearchBot für ChatGPT, Claude-SearchBot für Claude und PerplexityBot für Perplexity. Für das Training nutzen die Anbieter andere Bots, GPTBot bei OpenAI und ClaudeBot bei Anthropic. Du kannst also die Suche erlauben und das Training trotzdem sperren. Google-Extended steuert das Training von Gemini und das Grounding in den Gemini-Apps und Vertex AI. Laut Google hat er keinen Einfluss auf die Aufnahme in die Google-Suche, und dort erscheinen AI Overviews und AI Mode. Anbieter benennen Bots um und fügen neue hinzu, also schau bei jeder Überarbeitung der robots.txt in ihre Dokumentation.Welches Schema-Markup zählt am meisten für LLM SEO?
Organization mit sameAs-Links zu deinen offiziellen Profilen, BreadcrumbList und FAQPage nur dort, wo Fragen und Antworten auf der Seite sichtbar sind, so wie hier.Was sind die besten LLM-SEO-Tools 2026?
Wie lange dauert das LLM-SEO-Setup?
robots.txt prüfen, strukturierte Daten korrigieren, die nicht zur Seite passen, und optional eine llms.txt anlegen. Laut OpenAI und Perplexity dauert es rund 24 Stunden, bis eine geänderte robots.txt bei ihnen ankommt. Ob KI-Antworten dich danach zitieren, ist eine andere Frage, die kein Setup garantieren kann. Miss es also weiter, wenn die Änderungen live sind.Auditiere zuerst deine technische Schicht. Dann lass GEO sich verzinsen.
LLM SEO ist das Fundament, das alles darüber messbar macht. Truffles technisches Audit prüft Schema-Dichte, AI-Crawler-Freigaben, llms.txt-Status und Entity-Resolution-Lücken.
DSGVO-ready · Verschlüsselte Backups · Jederzeit kündbar.