Le LLM SEO : faire en sorte que les moteurs IA puissent lire ton site
Si le GEO, c'est ce que tu publies, le LLM SEO, c'est la question de savoir si les machines peuvent y accéder et le lire. Les permissions des crawlers passent en premier, puis des pages indexables et des données structurées conformes à ce que voit le visiteur. Bloque le mauvais crawler, et ChatGPT, Claude ou Perplexity peuvent ignorer tes pages sans que tu le saches. 94 % des acheteurs B2B se renseignent sur les vendeurs dans un moteur IA avant de cliquer sur une SERP. La couche technique sous ce chiffre détermine qui se fait citer.
Le paysage des moteurs · en un coup d'œil
| Moteur | Ce que c'est | Mesuré par Truffle |
|---|---|---|
| Assistants IA | ||
| OpenAI (ChatGPT) | Tourne dans chaque projet | ✓ |
| Anthropic (Claude) | Tourne dans presque chaque projet | ✓ |
| Google Gemini | Tourne dans chaque projet | ✓ |
| Perplexity | Tourne dans chaque projet | ✓ |
| xAI (Grok) | Activable par projet | ✓ |
| Surfaces de recherche Google | ||
| Google AI Overviews | Affiché sur 20 % des mots-clés (Sistrix, Allemagne, févr. 2026) | ✓ |
| Google AI Mode / top 10 de la SERP | Ligne de base de référence sur le même jeu de requêtes | ✓ |
Les moteurs actifs se configurent par projet, et une exécution en mesure plusieurs en parallèle : il n'y a pas de modèle de tête auquel les autres seraient comparés. Inclus dans chaque plan payant à partir de 69 $/mois, sans surcoût par moteur ni appel commercial. Les versions de modèles changent tous les quelques mois, ce tableau nomme donc des fournisseurs, pas des numéros de version.
Qu'est-ce que le LLM SEO ?
Le LLM SEO (Large Language Model SEO) est la discipline qui consiste à préparer l'infrastructure technique d'un site pour que les moteurs IA puissent explorer, parser, indexer et récupérer son contenu avec peu d'ambiguïté et une grande précision.
C'est la couche prérequise de l'AI SEO. Le GEO décide quoi publier pour que les modèles te citent. Le LLM SEO décide si les modèles peuvent techniquement accéder à ce contenu et le traiter.
Une proposition technique de ce domaine est le fichier llms.txt de Jeremy Howard (Answer.AI), publié pour la première fois en septembre 2024 : un résumé en markdown pour les LLM, placé à la racine du site ou, depuis la version 2 de la proposition, sous n'importe quel chemin, et nommé sur le modèle de robots.txt. Il répond à un problème que partage toute la discipline : les LLM peinent à extraire une information propre et canonique de sites optimisés pour les surfaces SEO traditionnelles.
Ce que cela veut dire en pratique :
Pour Google, il s'appuie sur le SEO technique. Google indique qu'AI Overviews et AI Mode n'ont pas d'exigences techniques au-delà de l'éligibilité normale à la recherche. Pour les autres moteurs, c'est différent : ChatGPT, Claude et Perplexity explorent avec leurs propres bots, et chacun s'autorise ou se bloque séparément.
Les données structurées doivent correspondre à la page. C'est exactement ce que demande Google, qui n'exige aucun balisage particulier pour ses fonctions IA. Autour, il y a la résolution d'entités, les permissions des crawlers IA dans robots.txt et la validation du balisage. Un fichier llms.txt vient en option.
Recherche et entraînement passent par des crawlers différents. Chez OpenAI, tu peux autoriser OAI-SearchBot, qui fait entrer tes pages dans les réponses de recherche de ChatGPT, tout en bloquant GPTBot, qui collecte des données d'entraînement. Anthropic sépare Claude-SearchBot et ClaudeBot de la même façon. Bloquer un crawler de recherche coûte de la visibilité dans les réponses de ce moteur, quoi que Google fasse de la même page.
Glossaire · quatre termes canoniques
robots.txt autorisant/bloquant des crawlers IA spécifiques (OAI-SearchBot, GPTBot, Claude-SearchBot, ClaudeBot, PerplexityBot, Google-Extended)Le paysage multimoteur de la recherche IA
La surface de recherche IA n'est plus « ChatGPT et les autres ». Chaque moteur génère désormais une distribution de requêtes réellement distincte. Optimiser pour l'un en ignorant le reste laisse les autres hors suivi.
| Moteur | Fournisseur | Type de requête | Crawler | Source d'indexation |
|---|---|---|---|---|
| ChatGPT (chat) | OpenAI | Conversationnel | GPTBot | Corpus d'entraînement + web en direct (Plus) |
| ChatGPT Search | OpenAI | Style recherche | OAI-SearchBot | Web en direct |
| Claude | Anthropic | Conversationnel | ClaudeBot · Claude-SearchBot | Corpus d'entraînement + usage d'outils |
| Perplexity | Perplexity | Recherche-citation | PerplexityBot | Web en direct, à chaque requête |
| Gemini | Conversationnel | Google-Extended | Corpus d'entraînement + index Google | |
| Google AI Overview | Intégré à la SERP | Googlebot | Index Google + synthèse IA |
L'implication technique
Autoriser Google-Extended ne fait pas entrer une page dans les AI Overviews. Selon Google, ce crawler ne joue aucun rôle dans l'inclusion dans la recherche Google, et AI Overviews et AI Mode sont des fonctions de la recherche qui suivent Googlebot (Google). Pour ChatGPT, Claude et Perplexity, ce sont leurs propres crawlers de recherche qui comptent : OAI-SearchBot, Claude-SearchBot et PerplexityBot, à vérifier séparément (OpenAI).
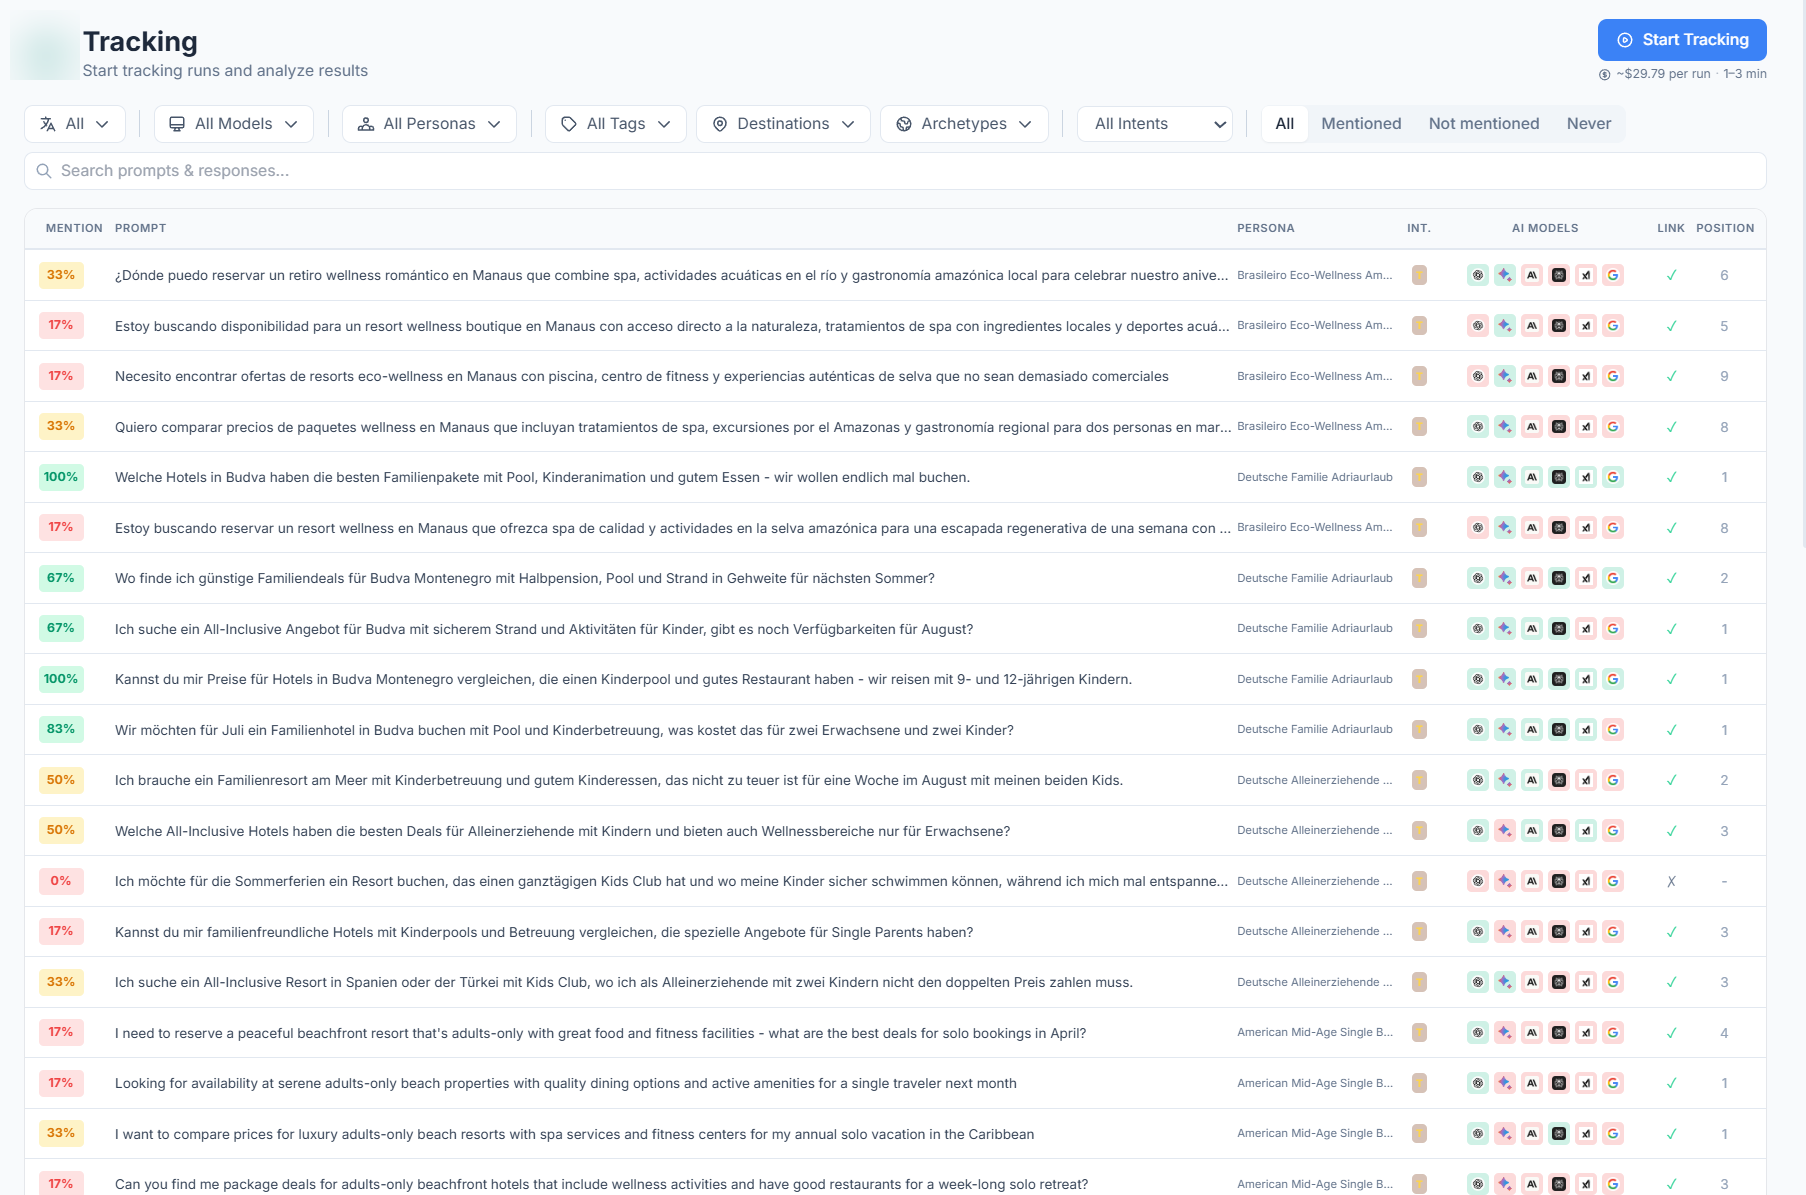
Live AI Visibility Check — suis de vraies requêtes, pas des traductions de mots-clés
La plupart des outils de LLM SEO simulent des prompts en traduisant des mots-clés SEO ("best CRM" → "What is the best CRM?"). Ça passe à côté de la façon dont les acheteurs interrogent réellement. Le Live AI Visibility Check de Truffle interroge en temps réel les réponses génératives de tous les moteurs connectés avec les vrais prompts qu'utilisent tes personas — générés, validés et actualisés automatiquement. Tu vois ce que ChatGPT a cité hier, pas ce qu'il pourrait citer si tes prompts étaient parfaitement formulés.
Où le LLM SEO se situe dans l'AI SEO Stack
Le playbook d'implémentation LLM SEO en 6 étapes
Les changements eux-mêmes sont limités. OpenAI et Perplexity parlent d'environ 24 heures avant de prendre en compte un robots.txt modifié. Seule une mesure suivie dira ensuite si tu es cité.
Permissions des crawlers IA dans robots.txt
Avant qu'un LLM puisse lire ton site, ton robots.txt doit l'autoriser. Des déclarations explicites réduisent l'ambiguïté :
User-agent: OAI-SearchBot
Allow: /
User-agent: Claude-SearchBot
Allow: /
User-agent: PerplexityBot
Allow: /
# Entraînement et Gemini : à toi de choisir
User-agent: GPTBot
Allow: /
User-agent: ClaudeBot
Allow: /
User-agent: Google-Extended
Allow: /
Échec courant : d'anciennes règles Disallow: * issues d'audits de confidentialité bloquent silencieusement les crawlers IA.
Fichier llms.txt à la racine ou sous un chemin
La proposition llms.txt de Jeremy Howard (Answer.AI) définit un fichier markdown, à la racine de ton domaine ou sous un chemin comme /docs/, qui résume ton site ou cette section pour les LLM. Ce n'est pas un remplaçant du sitemap.xml — un complément.
> Description en une phrase
## Ce que nous faisons
- Capacité 1
- Capacité 2
## Ressources clés
- [Tarifs](/tarifs)
- [Docs](/docs)
Adoption : 8,7 % des 1 000 plus gros sites (Rankability, juin 2026) — mais 97 % des fichiers publiés ne sont jamais demandés par un crawler IA (Ahrefs, 137K sites). Peu coûteux à poser, ce n'est pas un raccourci.
Balisage Schema.org, priorité FAQ
Le balisage schema signale une structure sémantique aux LLM. Ordre de priorité pour le LLM SEO :
1. FAQPage // densité IA la plus forte
2. Article // éducatif
3. HowTo // procédural
4. Organization // entité
5. BreadcrumbList
Les blocs FAQ fournissent au moteur de réponse des paires question-réponse prêtes à l'emploi — Single Grain cite le schema FAQ parmi les éléments qui alimentent les AI Overviews (Single Grain, 2026).
Résolution d'entités
Les LLM désambiguïsent les entités (marque, personne, produit, lieu) en les faisant correspondre à des identifiants canoniques. Ton site devrait référencer les entités par leur Q-ID Wikidata lorsque c'est applicable et utiliser le lien schema sameAs.
"https://www.wikidata.org/wiki/Q42",
"https://en.wikipedia.org/wiki/...",
"https://www.linkedin.com/in/..."
]
Échec courant : 5 bios de fondateur différentes sur le blog, la page à propos et le press kit → les LLM lisent 5 entités contradictoires.
Validation des données structurées, multi-surfaces
Un schema qui se valide sur Google Rich Results ne se parse pas nécessairement correctement pour les moteurs IA. Valide sur plusieurs surfaces :
1. Google Rich Results Test
2. Validateur Schema.org
3. Test en direct sur Perplexity
4. Test en direct sur ChatGPT
Un schema valide pour Google peut rester inutilisable pour un moteur de réponse — le plus souvent à cause d'un imbriquement JSON-LD incohérent. On teste moteur par moteur, pas une seule fois.
Monitoring continu des permissions multi-moteurs
Les LLM ajoutent régulièrement de nouveaux crawlers. Le T1 2026 a ajouté : OAI-SearchBot (ChatGPT Search), le ClaudeBot étendu d'Anthropic, Bytespider (TikTok AI).
Mensuel minimum
Trimestriel si faible trafic
Le robots.txt doit être mis à jour en continu, pas une fois par an.
Où les citations IA atterrissent vraiment
Les citations se répartissent entre les moteurs, et la répartition change selon la marque et le jeu de requêtes. N'optimiser que pour ChatGPT laisse le reste de cette surface à découvert — c'est pourquoi on mesure moteur par moteur, pas une seule fois.
Répartition illustrative. Il n'existe pas de mesure publique de la part de citations par moteur — Truffle mesure la répartition réelle de chaque marque.
Les outils de LLM SEO en 2026, côte à côte
Cinq plateformes, chacune conçue pour un type d'acheteur différent. « Non indiqué » signifie que la page du fournisseur ne donnait aucun chiffre à la date indiquée ci-dessous.
| Plateforme | Moteurs à l'entrée | Entrée |
|---|---|---|
| Truffle | 6 dans chaque plan | 69 $ |
| Profound | ChatGPT sur l'essai gratuit · jusqu'à 9 sur Enterprise | Non publié |
| AthenaHQ | 11 modèles sur Starter, facturés en crédits | 295 $ |
| Schema App | Non indiqué | Sur demande |
| WordLift | Non indiqué | 799 € (Business+) |
Prix des concurrents au 2026-09-17, relevés sur la page tarifaire de chaque éditeur. Les éditeurs modifient leurs offres sans préavis — vérifie auprès de l'éditeur avant de décider.
Lequel choisir
Si ta lacune se limite aux données structurées, un spécialiste du schema ou des entités peut suffire. S'il te faut voir ce que chaque moteur fait de ton site et agir en conséquence, il te faut aussi du suivi. Truffle est conçu pour les équipes qui veulent la boucle LLM SEO et GEO multimoteur dans un seul espace de travail.
Deux autres capacités Truffle qui bouclent le cycle LLM SEO
La Capacité 1 (Live AI Visibility Check) et la Capacité 4 (Smart Onboarding) sont présentées en ligne ailleurs sur cette page. Les Capacités 2 et 3 ci-dessous complètent la boucle éditoriale + technique du quotidien.
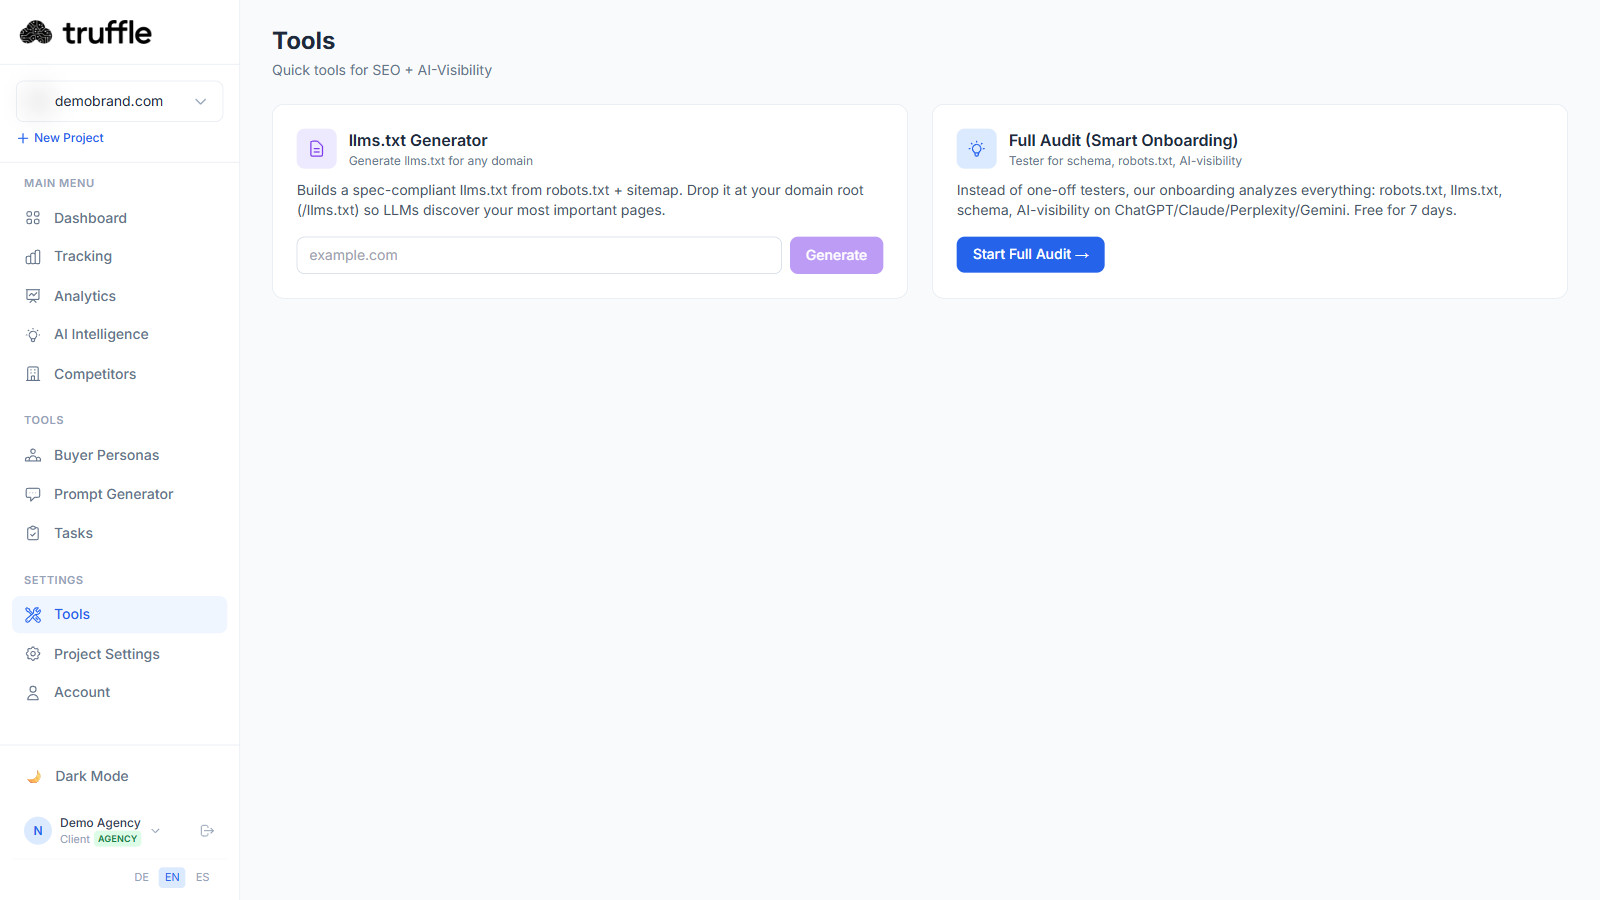
Tools — Générateur llms.txt + Audit complet (Smart Onboarding)
La section Tools de Truffle embarque deux utilitaires dédiés au LLM SEO. Le Générateur llms.txt produit un llms.txt conforme à la spec à partir de ton robots.txt + sitemap pour que les LLM découvrent tes pages importantes. L'Audit complet (Smart Onboarding) teste le schema, le robots.txt et la visibilité IA sur ChatGPT/Claude/Perplexity/Gemini en un seul flux.
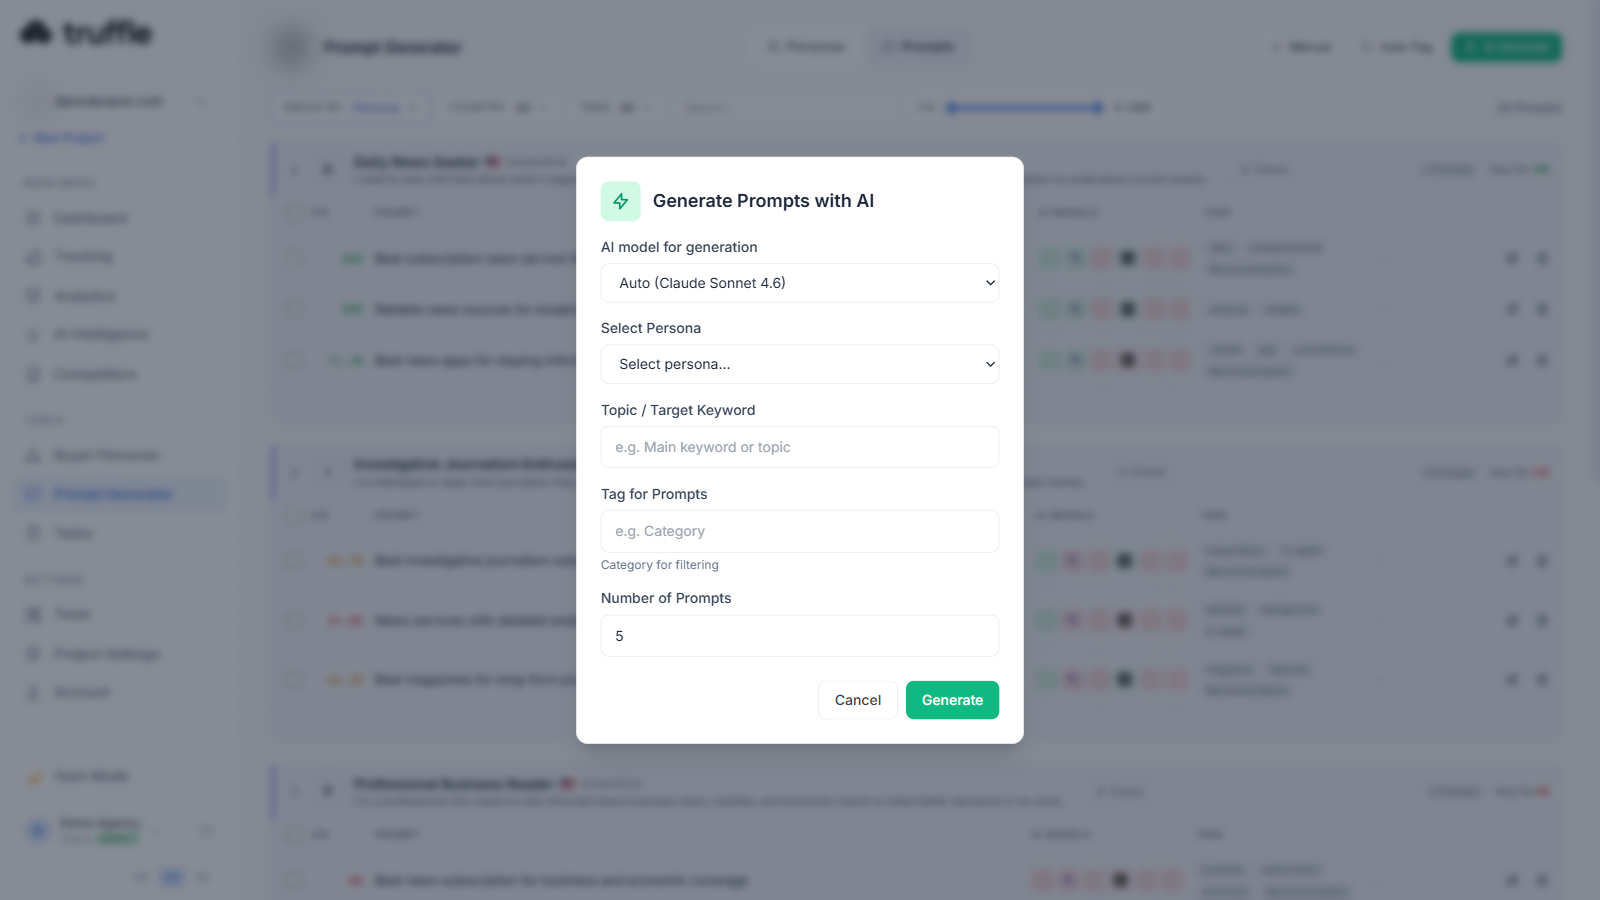
AI Generate · simulateur de prompts sur 10 modèles
Le LLM SEO exige de tester des prompts sur plusieurs moteurs sans payer 10 abonnements API distincts. AI Generate de Truffle exécute des prompts simulés sur les mêmes moteurs que ceux mesurés par le tracking (OpenAI, Anthropic, Google Gemini, Perplexity, xAI, plus les simulateurs AI Overview et SERP top-10) depuis une seule interface. Teste la capacité à être cité, la résolution d'entités des modèles, ébauche des variantes de schema — le tout dans un seul workflow.
Le marché de l'outillage LLM SEO en 2026
Fondamental et centré sur une configuration ponctuelle, donc moins de travail que des services GEO continus. L'effet de levier, lui, est permanent — le GEO sans LLM SEO laisse fuir des citations.
taux de clic en position 1 dès qu'une AI Overview s'affiche au-dessus
des mots-clés affichent une AI Overview — environ 30 % dans la longue traîne (marché allemand)
des 1 000 plus gros sites mondiaux publient un llms.txt — 97 % de ces fichiers ne sont jamais demandés par un crawler IA
Note sur les chiffres ci-dessus : les tailles de marché et les taux d'adoption incluent des projections d'experts et des modèles de tendance de cabinets d'études sectorielles — des données directionnelles crédibles, mais non vérifiées à la source unique d'une étude académique primaire. Méthodologie détaillée et liste des sources disponibles sur demande.
Smart Onboarding — analyse du site, personas et suivi prêts en quelques minutes
Les programmes de LLM SEO demandent en général 2 à 4 semaines de cadrage : analyser le site, ébaucher les buyer personas, construire le jeu de prompts initial, lancer le premier visibility check. Le Smart Onboarding de Truffle exécute toute la configuration via un assistant en 3 étapes guidé par IA : Analyse du site (secteur, audience, produits, proposition de valeur, concurrents détectés avec score de confiance), Contexte & Données (import CSV de la GSC et de GA + contexte additionnel) et Sélection des personas (5 personas suggérés par IA avec leurs prompts de suivi). Le premier visibility check tourne dans la même session.
Réserver une démo →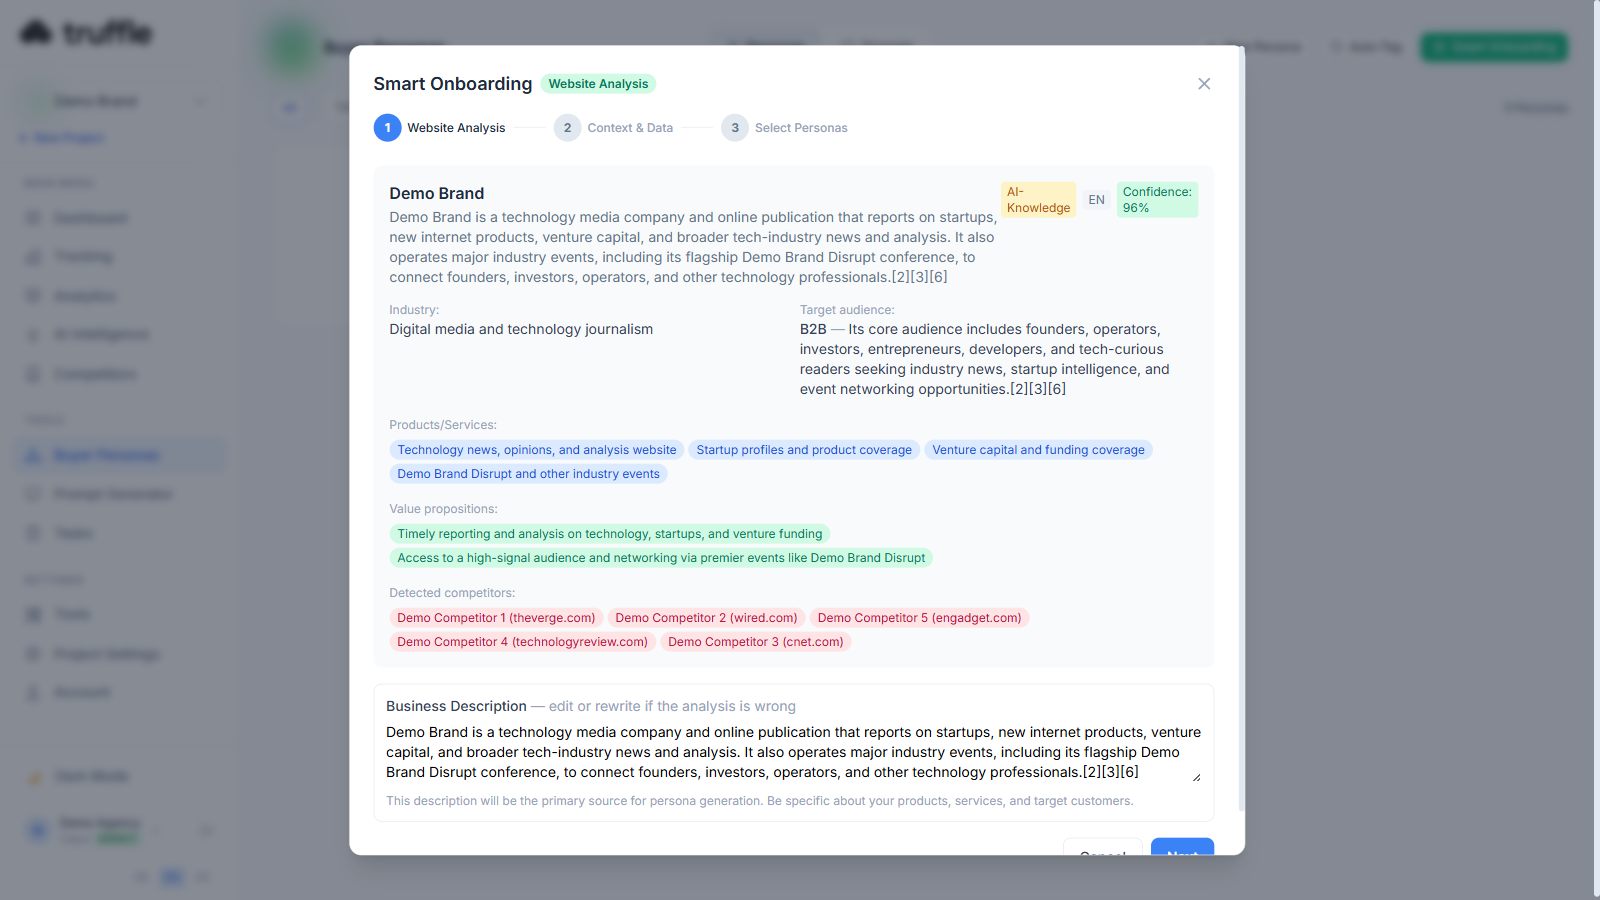
Questions fréquentes
Qu'est-ce que le LLM SEO ?
En quoi le LLM SEO diffère-t-il du SEO technique ?
robots.txt. Un site peut être impeccable pour Google et rester fermé pour eux.En quoi le LLM SEO diffère-t-il du GEO ?
OAI-SearchBot n'apparaissent pas dans les réponses de recherche de ChatGPT (ils peuvent encore figurer comme liens de navigation), quelle que soit la qualité du contenu.Ai-je besoin de llms.txt ?
llms.txt est une proposition de Jeremy Howard, publiée pour la première fois en septembre 2024, destinée à aider des agents comme les assistants de code à utiliser un site. Dans une étude d'Ahrefs portant sur 137 000 domaines, 97 % des fichiers publiés n'ont reçu aucune requête en mai 2026. Le créer demande peu d'effort, mais il ne remplace pas les permissions des crawlers.Quels crawlers IA devrais-je autoriser ?
OAI-SearchBot pour ChatGPT, Claude-SearchBot pour Claude et PerplexityBot pour Perplexity. L'entraînement passe par d'autres bots, GPTBot chez OpenAI et ClaudeBot chez Anthropic : tu peux donc autoriser la recherche et bloquer l'entraînement. Google-Extended contrôle l'entraînement de Gemini et le grounding dans les applis Gemini et Vertex AI. Google précise qu'il n'a aucun effet sur l'inclusion dans la recherche Google, là où apparaissent AI Overviews et AI Mode. Les éditeurs renomment leurs bots et en ajoutent, alors consulte leur documentation chaque fois que tu revois robots.txt.Quel balisage schema compte le plus pour le LLM SEO ?
Organization avec des liens sameAs vers tes profils officiels, BreadcrumbList, et FAQPage uniquement là où questions et réponses sont visibles sur la page, comme ici.Combien de temps prend la mise en place du LLM SEO ?
robots.txt, corriger les données structurées qui ne correspondent pas à la page et, si tu veux, ajouter un llms.txt. Selon OpenAI et Perplexity, un robots.txt modifié met environ 24 heures à arriver dans leurs systèmes. Être cité ensuite par les réponses IA est une autre affaire, qu'aucun réglage ne garantit : continue donc à mesurer une fois les changements en ligne.Audite d'abord ta couche technique. Puis laisse le GEO se capitaliser.
Le LLM SEO est la fondation qui rend tout ce qui se trouve au-dessus mesurable. L'audit technique de Truffle vérifie la densité de schema, les permissions des crawlers IA, le statut du llms.txt et les lacunes de résolution d'entités.
Conforme RGPD · sauvegardes chiffrées · résiliable à tout moment.